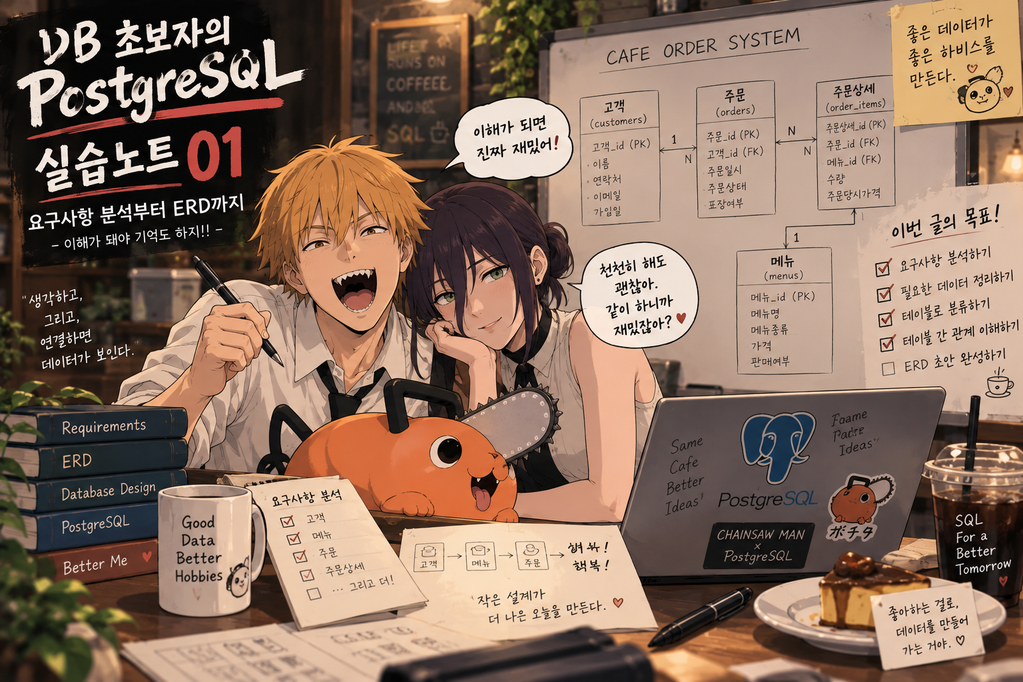
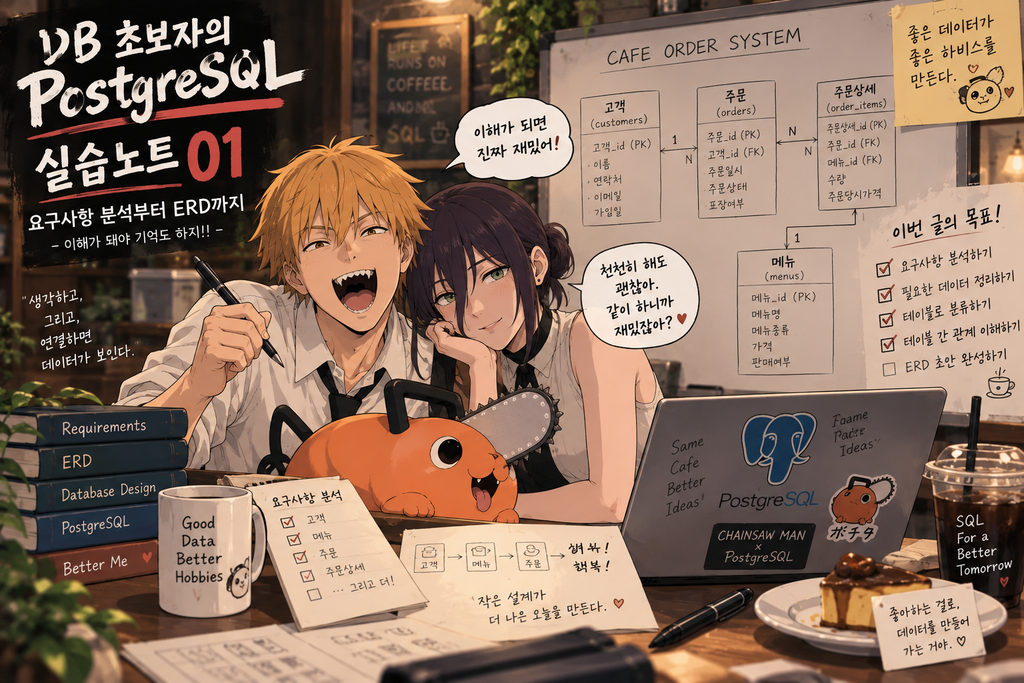
* 이번 글의 목표
실습은 모두 5개다. 이번 글은 1번, 카페 주문 및 메뉴 관리다.
- 카페 주문 및 메뉴 관리
고객, 메뉴, 주문, 주문상세 관리 - 도서 대여 관리
회원, 도서, 대여, 반납 관리 - 반려동물 병원 예약 관리
보호자, 반려동물, 수의사, 예약 관리 - 헬스장 회원·수업 예약 관리
회원, 강사, 수업, 예약 관리 - 스터디 모임 및 참여자 관리
회원, 스터디 그룹, 모임, 참여 신청 관리
이 글은 이렇게 흘러간다.
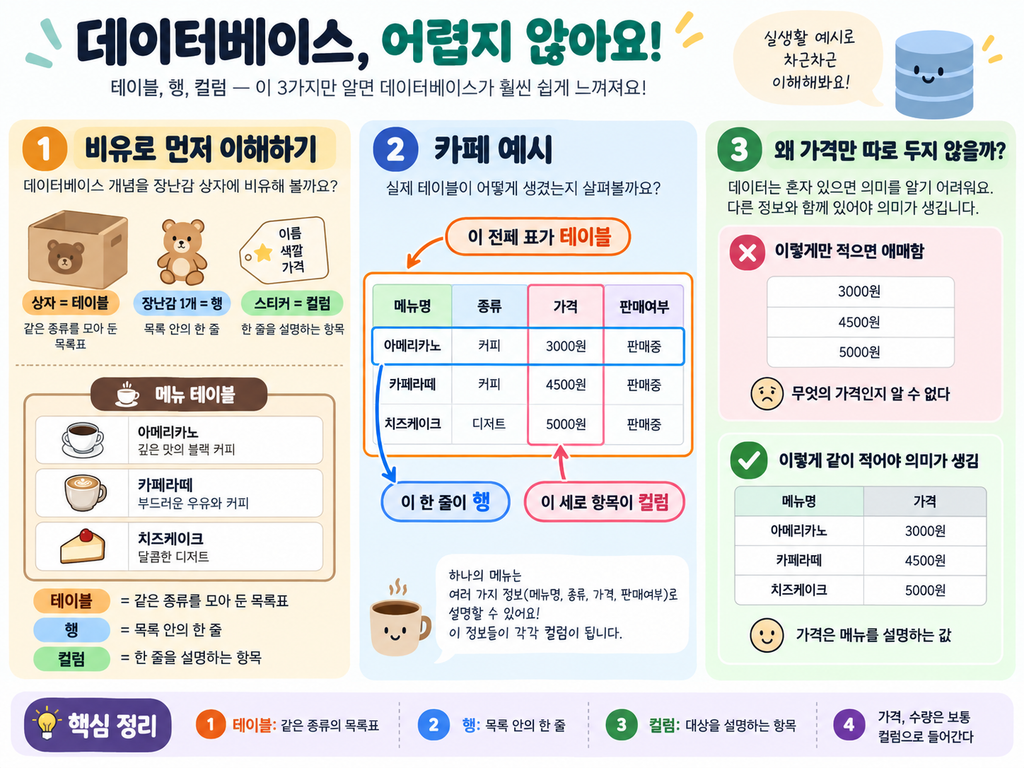
이 글은 PostgreSQL 문법을 바로 쓰기 전, 요구 사항에 대한 DB를 어떻게 설계할지 먼저 생각해보는 글이다. 지금은 훑어보고 넘어가자.
| 한국어 | 영어 표기 | 간단 설명 |
|---|---|---|
| 테이블 | Table | 같은 종류의 데이터를 저장하는 표 |
| 행 | Row / Record | 테이블에 저장된 실제 데이터 한 건 |
| 컬럼 | Column / Field | 각 데이터가 가지는 항목 |
| 기본키 | Primary Key / PK | 한 행을 구분하는 고유한 값 |
| 외래키 | Foreign Key / FK | 다른 테이블의 행과 연결하는 값 |
첫 번째 실습은 카페 주문 및 메뉴 관리다.
1. 요구사항 분석으로 시작
요구사항 분석? 무슨 요구사항을 분석한다는 말이야?
내가 만들고 싶거나, 의뢰받은 서비스가 어떤 정보와 흐름을 가지는지 먼저 정리하는 단계다.
카페로 예를 들면 “카페 주문 관리 프로그램을 만든다면 어떤 정보를 저장해야 할까?”를 생각해보는 것이다.
카페에는 고객과 메뉴가 있고, 고객은 메뉴를 주문한다. 주문에는 여러 메뉴가 들어갈 수 있다.
그러면 먼저 찾아야 할 것은 고객 / 메뉴 / 주문 / 주문 안의 메뉴 정보다.
이 외에도 가격, 수량, 테이블 번호, 할인, 테이크아웃 등이 떠오를 수 있다.
처음에는 다 적어보고, 그다음에 분류해보자.
SQL을 작성하기 전에 이렇게 먼저 생각해보는 게 시작이다.
2. 왜 이렇게 먼저 생각해봐야 할까?
카페 업무는 현실에서는 하나의 흐름이다.
고객이 와서 메뉴를 고르고, 수량을 말하고, 포장 여부와 결제를 정한 뒤 주문을 완료한다.
그런데 컴퓨터는 이 흐름을 그대로 “상황”으로 기억하지 못한다.
그래서 정보를 잘게 나눠, 정리된 형태로 저장해야 한다.
3. 그래, 그럼 어떻게 분류하면 되는데?
단순하게 혼자 관리할 대상인가? 아니면 다른 대상을 설명하는 값인가?
고객은 혼자 관리할 수 있다. 이름, 연락처, 이메일이 있기 때문이다.
메뉴 – 메뉴명, 종류, 기본 가격
주문 – 누가 언제 주문했는지를 기록해야 하기 때문이다.
수량? 수량만 따로 저장하면 의미가 없다.
왜? 주문 “2개”라고만 있으면 무엇이 2개인지 알 수 없기 때문이다.
그래서 수량은 주문 안의 메뉴를 설명하는 값이다.
가격도 같은 이유다.
4. 분류해보자
나올 수 있는 정보: 고객, 메뉴, 주문, 가격, 수량, 주문 시간, 판매 여부, 할인, 포장 여부
이제 이것을 두 가지로 나눈다.
같은 종류의 것을 모아두는 목록표인지, 그 목록표 안에 들어가야 할 요소인지.
예를 들면:
과자 상자(목록표) → 과자, 젤리, 초콜릿
장난감 상자(목록표) → 자동차, 블록, 공
옷 상자(목록표) → 티셔츠, 바지, 양말
돌아와서 카페로 바꾸면,
고객 상자 → 고객의 정보가 들어간다. (이름, 나이, 성별, 생일) 회원제라면.
메뉴 상자 → 아아, 아라, 스무디, 차 등
주문 상자 → 고객이 주문한 주문 한 건씩 추가된다.
주문상세 상자 → 주문 안의 메뉴 줄이 들어간다.
즉, 테이블 = 같은 종류의 것을 모아두는 목록표
행 = 그 목록 안에 들어가는 하나
컬럼 = 그 하나를 설명하는 항목
지금까지는 머릿속에 떠오르는 정보를 전부 꺼내는 단계였다.
다음은 분류표를 작성하는 단계다.
- 후보 목록 예시 –
고객, 메뉴, 주문, 가격, 수량, 주문 시간, 판매 여부, 할인, 포장 여부, 이메일, 연락처,메뉴 종류, 주문 상태
작성 형식:
| 분류명1 |
| 분류항목1 |
| 분류항목2 |
| 분류항목3 |
| 분류항목4 |
| 분류명2 |
| 분류항목1 |
| 분류항목2 |
| 분류항목3 |
| 분류항목4 |
| 분류명3 |
| 분류항목1 |
| 분류항목2 |
| 분류항목3 |
| 분류항목4 |
| 분류명4 |
| 분류항목1 |
| 분류항목2 |
| 분류항목3 |
| 분류항목4 |
이렇게 표로 만들어보면서 분류하면 더 직관적으로 확인할 수 있다.
항목을 꽉 채우지 않아도 된다! 할 수 있는 만큼만 채워보자.
이렇게 분류하면
분류표명(같은 종류의 정보를 모아둔 표) = 테이블명
분류 항목(표 안에서 저장할 항목) = 컬럼
추가되는 실제 데이터 한 줄 = 행(Row)
이 된다.
즉, 고객이라는 분류표를 만들었다면
- 분류표 명(테이블): 고객
- 분류 항목(컬럼): 이름, 연락처, 이메일, 가입일
- 추가되는 데이터(행): 포치타 / 010-1234-5678 / abc@email.com / 2026-09-09
즉, 지금 이 과정은
단순히 표를 그리는 게 아니라,
현실의 정보를
데이터베이스의 구조로 바꾸어 보는 과정이다.
여기까지 테이블, 컬럼, 행이 무엇인지 정도는 이해됐길 바란다.
완성한 형태는 아래와 같다.
이제 테이블 사이가 어떻게 연결되는지 생각해보자.
테이블을 연결할 때 중요한 컬럼은 고객 번호, 메뉴 번호, 주문 번호 같은 번호들이다.
이어서 설명하겠지만, 이 번호들은 누가 어떤 주문을 했는지 헷갈리지 않게 하는 기준이다.
손님이 입장해서 주문하고 그것이 처리되는 흐름을 따라가며 보면 이해하기 쉽다.
첫 번째 손님을 “포치타”라고 하자. 포치타는 고객 번호 1번이다.
고객 번호 1번인 포치타가 주문표에서 주문하면 주문번호 1번이 생긴다.
주문상세표에는 주문번호 1번에 대한 상세 행이 3개 들어갈 수 있다.
이때 주문상세표의 메뉴 번호를 보고 메뉴표에서 메뉴 이름과 가격을 확인한다.
우선 다시 실제 흐름을 생각해보자
첫 번째 손님이 들어와 주문했을 때, 각 항목에 어떤 정보가 들어가는지 먼저 생각해본다.
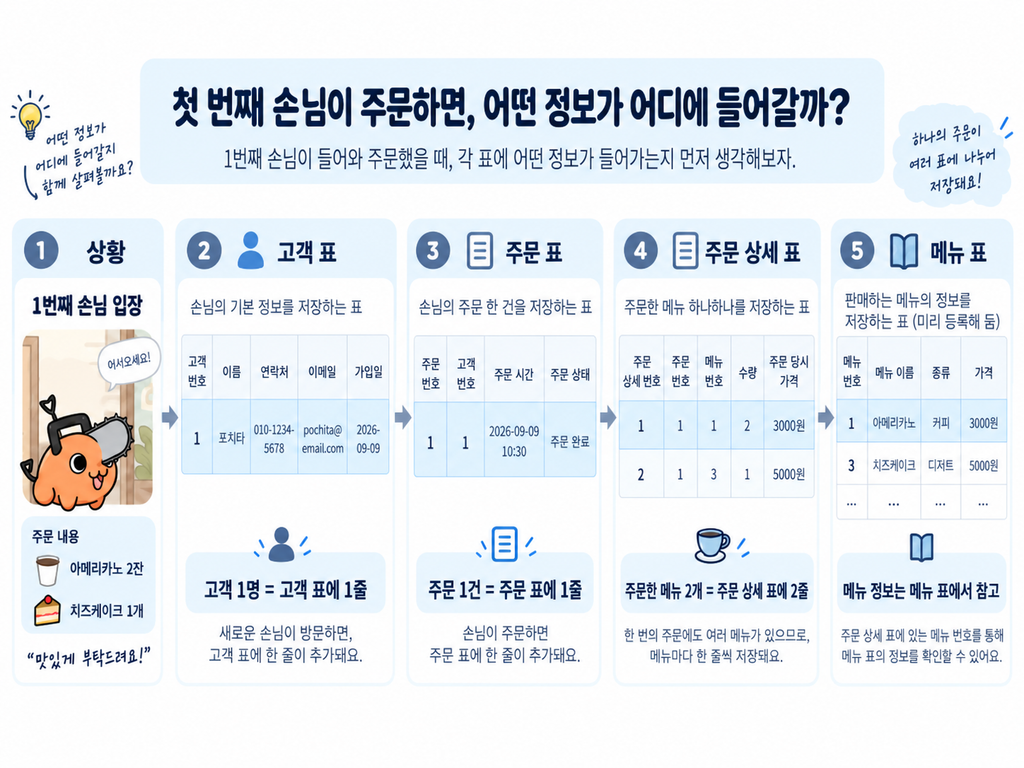
이렇게 처리하려면 테이블 간의 관계를 만들 기준이 필요하다.
그래서 고유번호, 즉 PK(기본키)를 둔다.
각 테이블에 추가되는 정보를 구분하기 위한 고유번호 정도로 이해하자.
이 고유번호는 중복되거나 비어 있으면 안 된다.
그리고 이 고유번호가 다른 테이블에 들어가 연결 역할을 하면 FK(외래키)라고 한다.
간단히 정리하면
PK = 각 테이블에서 원하는 한 줄(데이터)을 정확히 찾기 위한 고유번호
FK = 다른 테이블의 한 줄을 가리키는 연결 번호
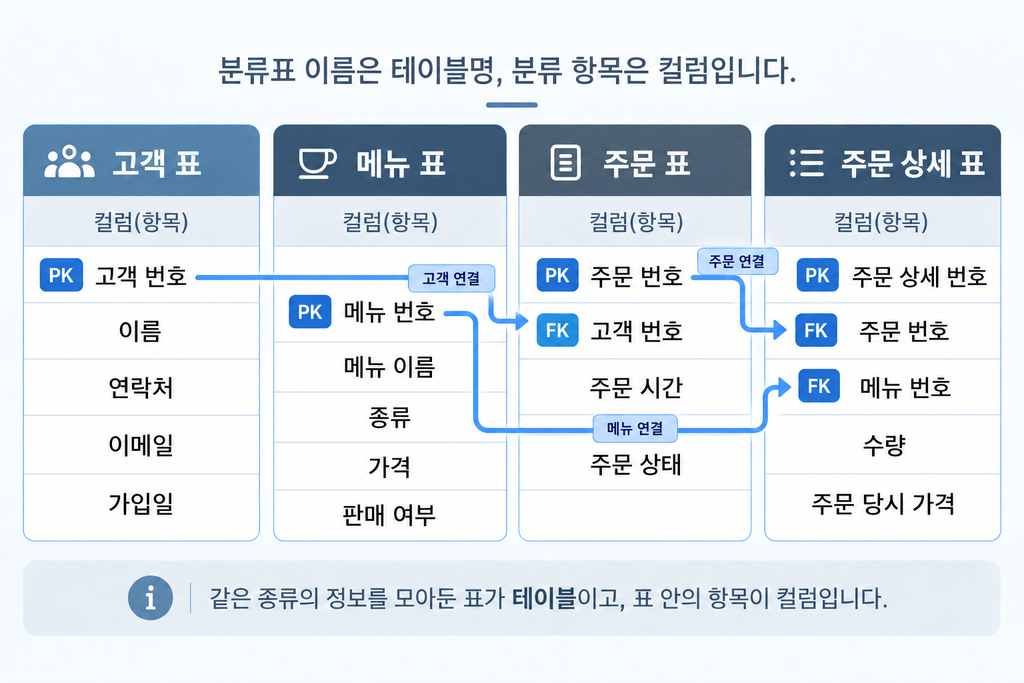
이 카페 예시에서 테이블 관계는 대부분 1:N으로 생각해볼 수 있다.
응? 이건 또 왜?
그런데 주문상세표를 보면 의아한 점이 있었을 수도 있다.
수량은 메뉴표에 들어가도 될 것 같고, 주문표에 들어갈 수도 있을 것 같다.
주문 당시 가격도 메뉴표나 주문표에 들어가도 될 것처럼 애매하다.
한눈에 확인해보자.
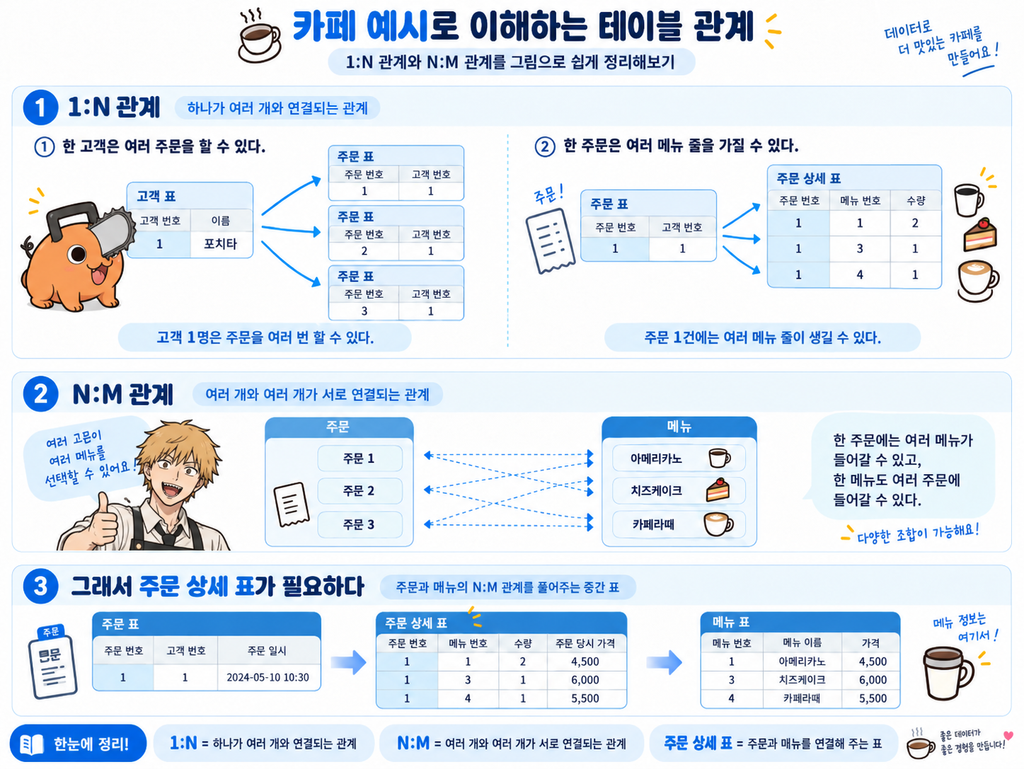
그래서 주문상세 테이블을 만들어 중간 연결 테이블로 사용한다.
그래서 그게 뭐냐고?
카페 주문을 생각해보자. 포치타라는 고객이 있다.
포치타는 오늘도 주문할 수 있고, 내일도 다시 주문할 수 있다.
즉, 고객 한 명은 여러 번 주문할 수 있다.
그래서 고객과 주문은 1:N 관계라고 표현한다.
쉽게 말하면 고객 1명 → 주문 여러 건, 이런 구조다.
이번에는 주문 하나를 보자.
포치타가 주문 1번에서 아메리카노, 치즈케이크, 카페라떼를 같이 주문했다고 하자.
그러면 주문 1번 안에는 메뉴가 여러 개 들어간다.
즉, 주문 1건 → 주문상세 여러 줄. 이것도 1:N 관계다.
주문상세는 영수증 안에 적힌 메뉴 줄이라고 보면 된다.
그런데 주문과 메뉴를 보면 관계가 조금 더 복잡하다.
한 주문에는 여러 메뉴가 들어갈 수 있다.
반대로 아메리카노 같은 메뉴도 여러 주문에 들어갈 수 있다.
즉, 주문과 메뉴는 서로 여러 개씩 연결된다. 이걸 N:M 관계라고 한다.
문제는 N:M 관계를 그대로 표에 넣기 어렵다는 것이다.
주문표에 메뉴를 전부 넣으면 메뉴 1, 메뉴 2, 메뉴 3처럼 컬럼이 계속 늘어난다.
메뉴가 많아질수록 표가 금방 복잡해진다.
그래서 중간에 주문상세표를 둔다.
주문상세표는 주문과 메뉴 사이를 연결한다.
예를 들어 주문 1번에 아메리카노 2잔, 치즈케이크 1개가 있다면 주문상세표에는 이렇게 들어간다.
주문 1번 / 아메리카노 / 2잔
주문 1번 / 치즈케이크 / 1개
즉, 주문상세는 한 주문 안의 메뉴들을 줄 단위로 정리하는 표다.
중간 테이블이 있고 없고의 차이를 확인해보자.
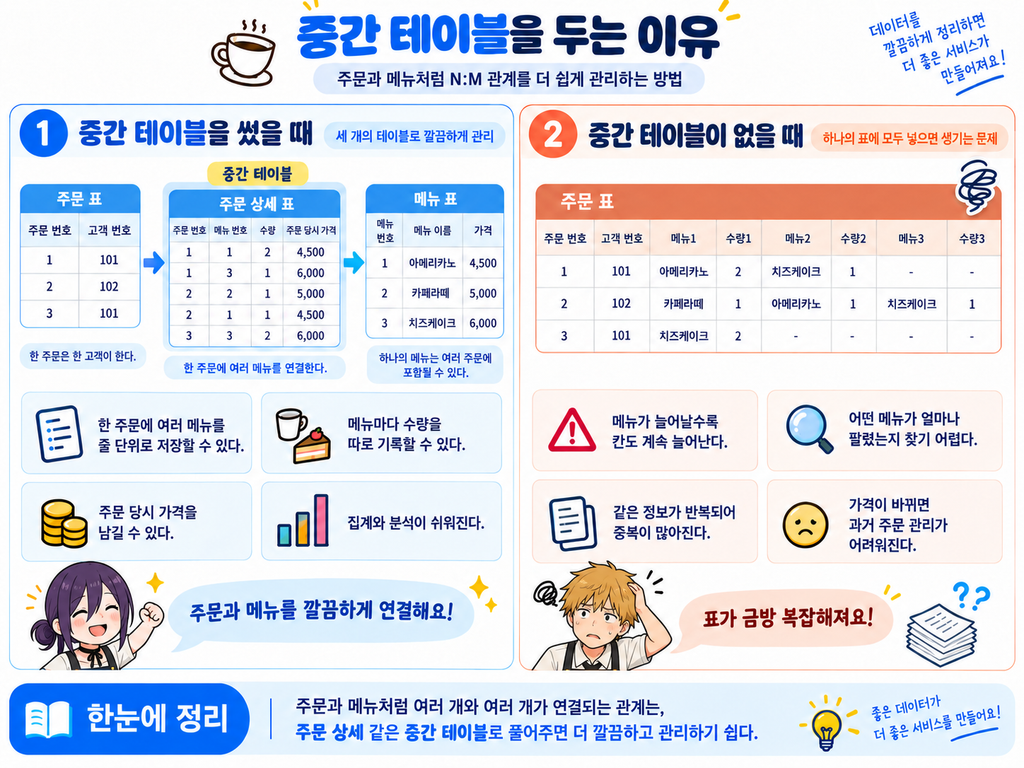
한 주문 안에 여러 메뉴가 들어갈 수 있기 때문이다.
예를 들어 포치타가 와서 아메리카노 2잔, 치즈케이크 1개,
카페라떼 1잔을 주문했다고 하자.
이걸 주문 표에 전부 넣으려고 하면
메뉴 1, 수량 1, 메뉴 2, 수량 2, 메뉴 3, 수량 3처럼
표가 점점 지저분해진다.
처음에는 괜찮아 보여도, 메뉴가 5개, 10개가 되면 컬럼을 계속 늘려야 한다.
그래서 주문 표에는 주문 한 건의 정보만 남긴다.
예를 들면 누가 주문했는지, 언제 주문했는지, 주문 상태가 무엇인지 정도다.
그리고 실제 주문한 메뉴들은 주문 상세 표에 따로 적는다.
즉, 영수증으로 비유하면 이렇다. 주문 표는 영수증 한 장이다.
주문 상세 표는 영수증 안의 메뉴 줄이다.
영수증 한 장 안에 아메리카노 2잔, 치즈케이크 1개가 적히는 것처럼,
주문 상세 표에는 주문한 메뉴가 한 줄씩 들어간다.
이렇게 하면 좋은 점은 명확하다.
메뉴가 몇 개든 깔끔하게 저장할 수 있다.
메뉴별 수량도 정확히 관리할 수 있다.
나중에 어떤 메뉴가 많이 팔렸는지도 쉽게 계산할 수 있다.
한 줄로 정리하면:
중간 테이블은 복잡한 주문 내용을 메뉴별 한 줄로 풀어서 정리하는 표다.
그럼 중간 테이블인지 아닌지는 이렇게 판단하자.
두 대상이 서로 여러 개씩 엮이면
중간 테이블을 의심한다.
예를 들어 카페에서는:
한 주문에 메뉴가 여러 개 들어갈 수 있나?
→ 그렇다.
한 메뉴도 여러 주문에 들어갈 수 있나?
→ 그렇다.
그러면 주문과 메뉴는 N:M 관계가 된다.
이때는 보통 중간 테이블이 필요하다.
더 간단하게!
A도 B를 여러 개 가질 수 있고,
B도 A에 여러 번 등장할 수 있으면
중간 테이블을 둔다.
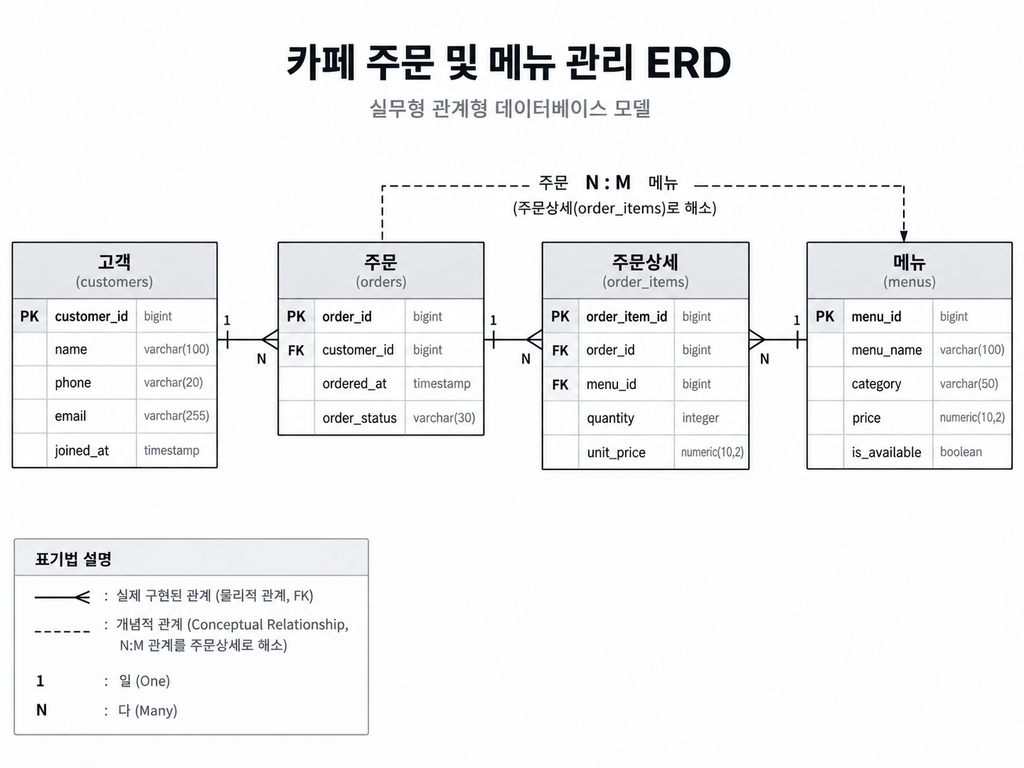
그렇게 정리하고 나면, 아래와 같은 ERD로 깔끔하게 볼 수 있다.
To be continued..
Next.
CRUD를 이해하고 Datebase와 Schema 까지 만들어본다
ERD초안을 가지고 CRUD를 이해하고
Datebase와 Schema 까지 만들어본다.